

实际使用与边界
适用场景:把本文当作发布日评测清单:固定有代表性的编程、文件、工具调用和长上下文任务,再与现有模型比较正确率、延迟、token、失败、许可和数据处理。
边界:Hy4 preview 的规格、接入、价格和文档可能变化。腾讯盲测属于内部评测,不是独立的普遍基准;本文不是模型推荐,也不构成性能保证。
简短结论:规模很大,但目标是实际工作流
腾讯在 2026 年 8 月 28 日发布 Hy4 preview,并把它定位为面向生产力的开源前沿模型。最醒目的规格包括:总参数 7700 亿、每个 token 激活参数 490 亿,以及超过 100 万 token 的上下文长度。这些数字让发布本身很重要,却不能直接回答开发者是否应该采用它。更实用的问题是:当任务包含代码仓库、多个文件、工具调用和交付约束时,Hy4 的长上下文和智能体行为是否仍然可靠。本文把已披露事实与仍需验证的测试分开。
架构数字意味着什么,又不意味着什么
Hy4 采用混合专家架构:模型拥有很大的参数池,但每个 token 只激活其中一部分。腾讯披露总参数 770B、激活参数 49B。激活参数较少,可能相对于 770B 稠密模型降低部分推理成本,但这不代表模型很轻。权重显存、运行时开销、专家通信、量化、批处理和服务框架,都会决定团队能否运行它。百万级上下文同样只是容量指标,并不保证长提示中的每个细节都能被准确取回,也不保证长输入一定经济。
腾讯披露的证据有吸引力,但边界很清楚
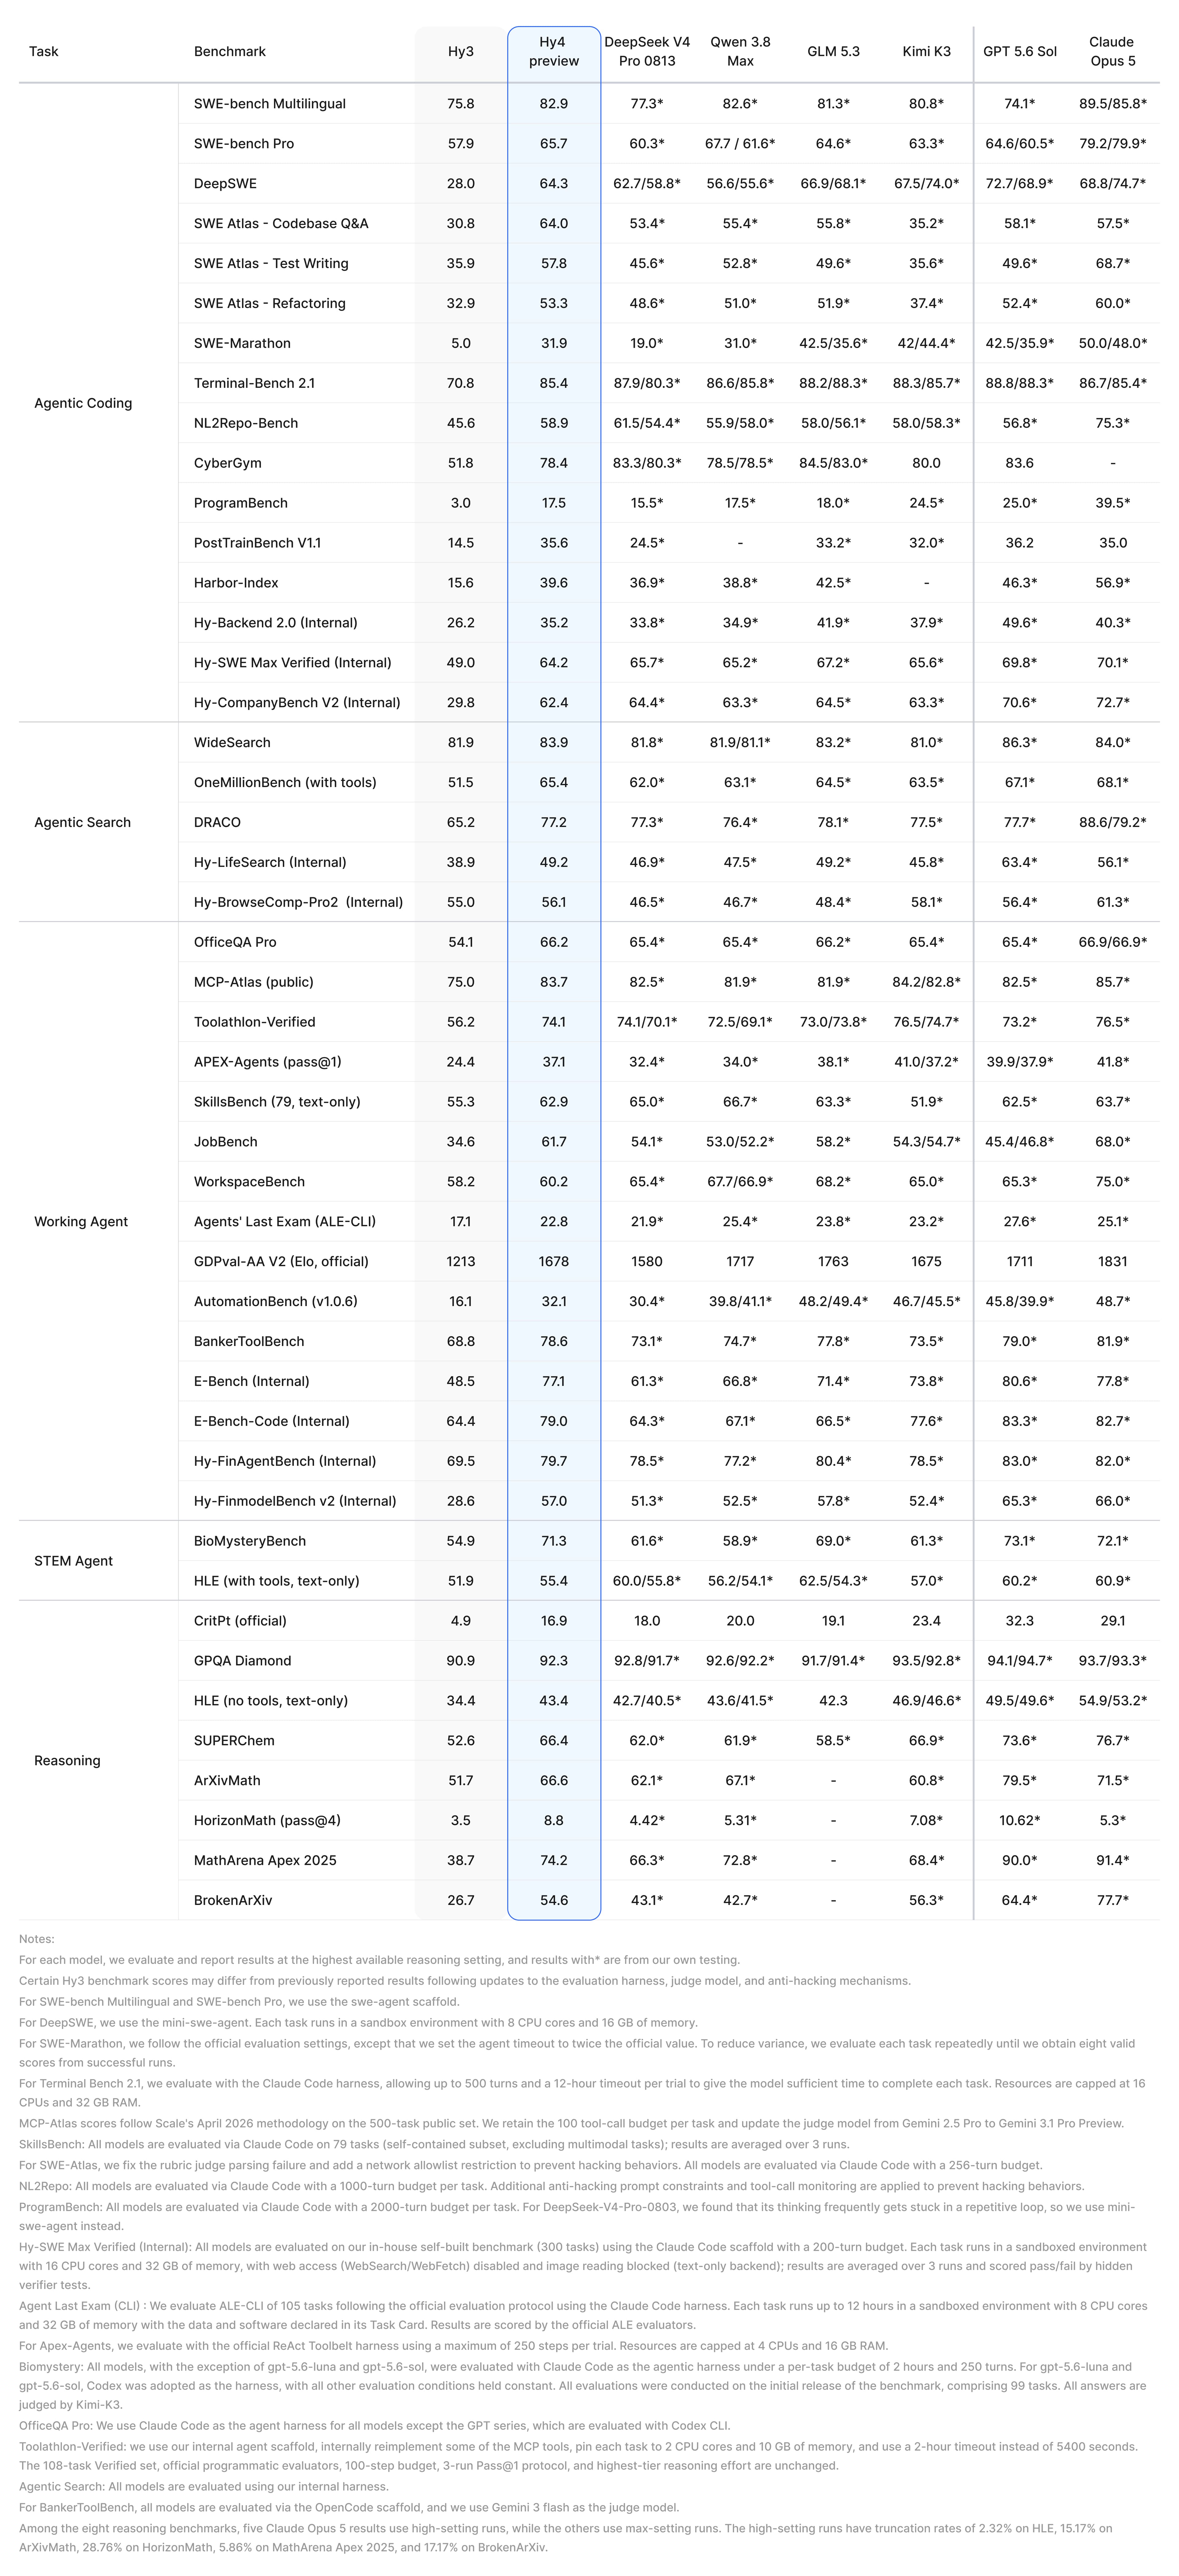
腾讯表示,它组织了 163 名内部专家,针对 203 个工程任务进行了盲测。Hy4 preview 平均得分 2.99/4,GLM-5.3 为 2.92,Kimi K3 为 2.94。这个结果值得关注,因为任务比单一公开问答更接近真实工程工作。但它仍是内部评测:任务集、抽样过程、评分者校准、提示词、工具权限、错误处理和统计不确定性,并不足以证明普遍排名。更合理的用法是把它当成值得测试 Hy4 的理由,而不是它能赢下所有编程和推理任务的证明。
模型重点面向哪些工作
发布信息强调了四类工作。软件工程方面,腾讯强调长程规划、调试、验证和前端交互质量;办公与分析方面,重点是跨文件理解、金融分析以及文档、表格和演示文稿交付;游戏开发方面,目标是把自然语言需求转成可玩的原型,并通过游戏引擎持续迭代;科研方面,则提到 AI 研发、分子动力学、凝聚态物理和基础数学等复杂问题。这些是产品方向,不是独立能力证书。正式评测应使用固定评分标准测试自己的任务,并像记录成功一样记录失败。
接入、价格和上线前的运营问题
腾讯表示,Hy4 preview 同步接入 WorkBuddy 或 CodeBuddy、元宝和 ima,开发者可以通过腾讯云 TokenHub 和 OpenRouter 访问。发布价格为每百万输入 token 6 元、每百万输出 token 18 元、缓存命中每百万 token 0.3 元。迁移工作负载前,应确认准确的模型 ID、地区、速率限制、计费单位、缓存行为、数据保留、服务稳定性,以及 API 是否按你的应用需要返回工具调用和推理字段。低 token 价格可能被重试、过长输出、延迟和更多人工复核抵消。
一套稳妥的开发者测试方案
先用自己的工作做一个小而可撤销的基准。固定 10—20 个任务,覆盖编程、文件抽取、表格推理、工具调用和长上下文检索。给不同模型相同的文件、指令、时间预算和工具权限,记录正确性、完整性、人工修改量、延迟、输入输出 token、失败恢复以及不安全或过度自信的行为。仓库任务要求提交补丁、测试和简短说明;文件任务要求引用提供的材料;智能体任务记录每一次工具调用。和现有模型比较,并保留被拒绝的输出,这比重复 vendor 榜单更有用。
开源标签仍需核对许可和部署条件
只有当权重、代码、许可证、模型卡、硬件要求和再分发条款足够清晰时,‘开源’才真正对你的场景有价值。应检查本次发布的准确仓库和文件,不要默认沿用早期 Hy 模型的条款。然后测试支持的推理框架、量化质量、多卡通信、冷启动时间和显存余量。技术上可以下载的模型,未必适合小团队自托管;API 部署也会带来与自托管不同的隐私和数据治理义务。
结论:测试工作流,不要只看 headline
Hy4 preview 的意义在于,它把超大规模混合专家模型、百万级上下文、开放权重,以及腾讯产品和外部 API 渠道结合在了一起。它最值得早期测试的场景,是长流程、需要工具协作的生产力工作。但现有证据还不是普遍性能结论,preview 标签也意味着行为、价格、可用性和文档可能快速变化。开发者应做任务级比较,核对许可与数据处理,并在生产使用前设置回退方案。本文是对新发布的独立解读,不构成采用建议,也不保证性能。
常见问题
Hy4 preview 已经是完成度很高的生产模型吗?
不是。它是 preview 版本。发布规格和接入路径可以作为起点,但正式部署前仍应以官方模型页面核对当前可用性、行为、价格和文档。
770B 是否意味着 Hy4 一定比小模型好?
不意味着。总参数是架构规模,不是普遍质量分数。激活参数和百万级上下文会改变工程取舍,任务准确率、延迟、成本和可靠性仍需直接测试。
小团队可以本地运行 Hy4 吗?
不能仅凭发布公告判断。需要核对准确权重、量化方案、许可证、硬件要求、推理框架和显存占用。API 可能更实际,但会引入成本和数据治理问题。